※ 本文轉寄自 ptt.cc 更新時間: 2026-09-29 18:18:07
看板 PC_Shopping
作者 標題 Re: [閒聊] RTX3090 單/雙卡 本地LLM運算AI電腦心得
時間 Mon Sep 28 22:28:46 2026
※ 引述《ZMTL (Zaious.)》之銘言:
: 先上組好圖
: https://imgs.plurk.com/QHO/ESJ/LMCfqiXl7TN0oC1300Y2hCUHhFZ_lg.jpg
: ------------
: 雙3090配置
: CPU (中央處理器):i5-12400
: MB (主機板):MSI Z690 FORCE WIFI
: RAM (記憶體):威剛 64GB(32GB*2) DDR5-4800
: VGA (顯示卡):ZOTAC RTX 3090 TRINITY 24G
: MSI RTX 3090 Suprim X
: SSD (固態硬碟):Kingston金士頓 KC3000 1TB M.2
: PSU (電源供應器):振華 Leadex 1200W
: CHASSIS (機殼):Phanteks Enthoo Pro 2 Server Edition + 9 顆 TL-C12C-S
: 只留下了CPU、SSD、一張3090,沒了,對,就是這麼坑
: 因為雙3090跑LLM,LLM要能把模型拆給兩張跑需要能讓兩張PCIE直連8x/8x的主機板,
: 這個條件,基本上DDR4的主機板中沒有。
...
因為有人寫信問我心得,事隔半年剛好回饋一下。
先給結論- 現在玩AI不用硬追雙 3090 但至少要一張跑 Qwen27B & 後悔沒買雙 64G DRAM.
以下正文:
------------
框架與參數
http://go.chroniclecore.com/d/nodes.png
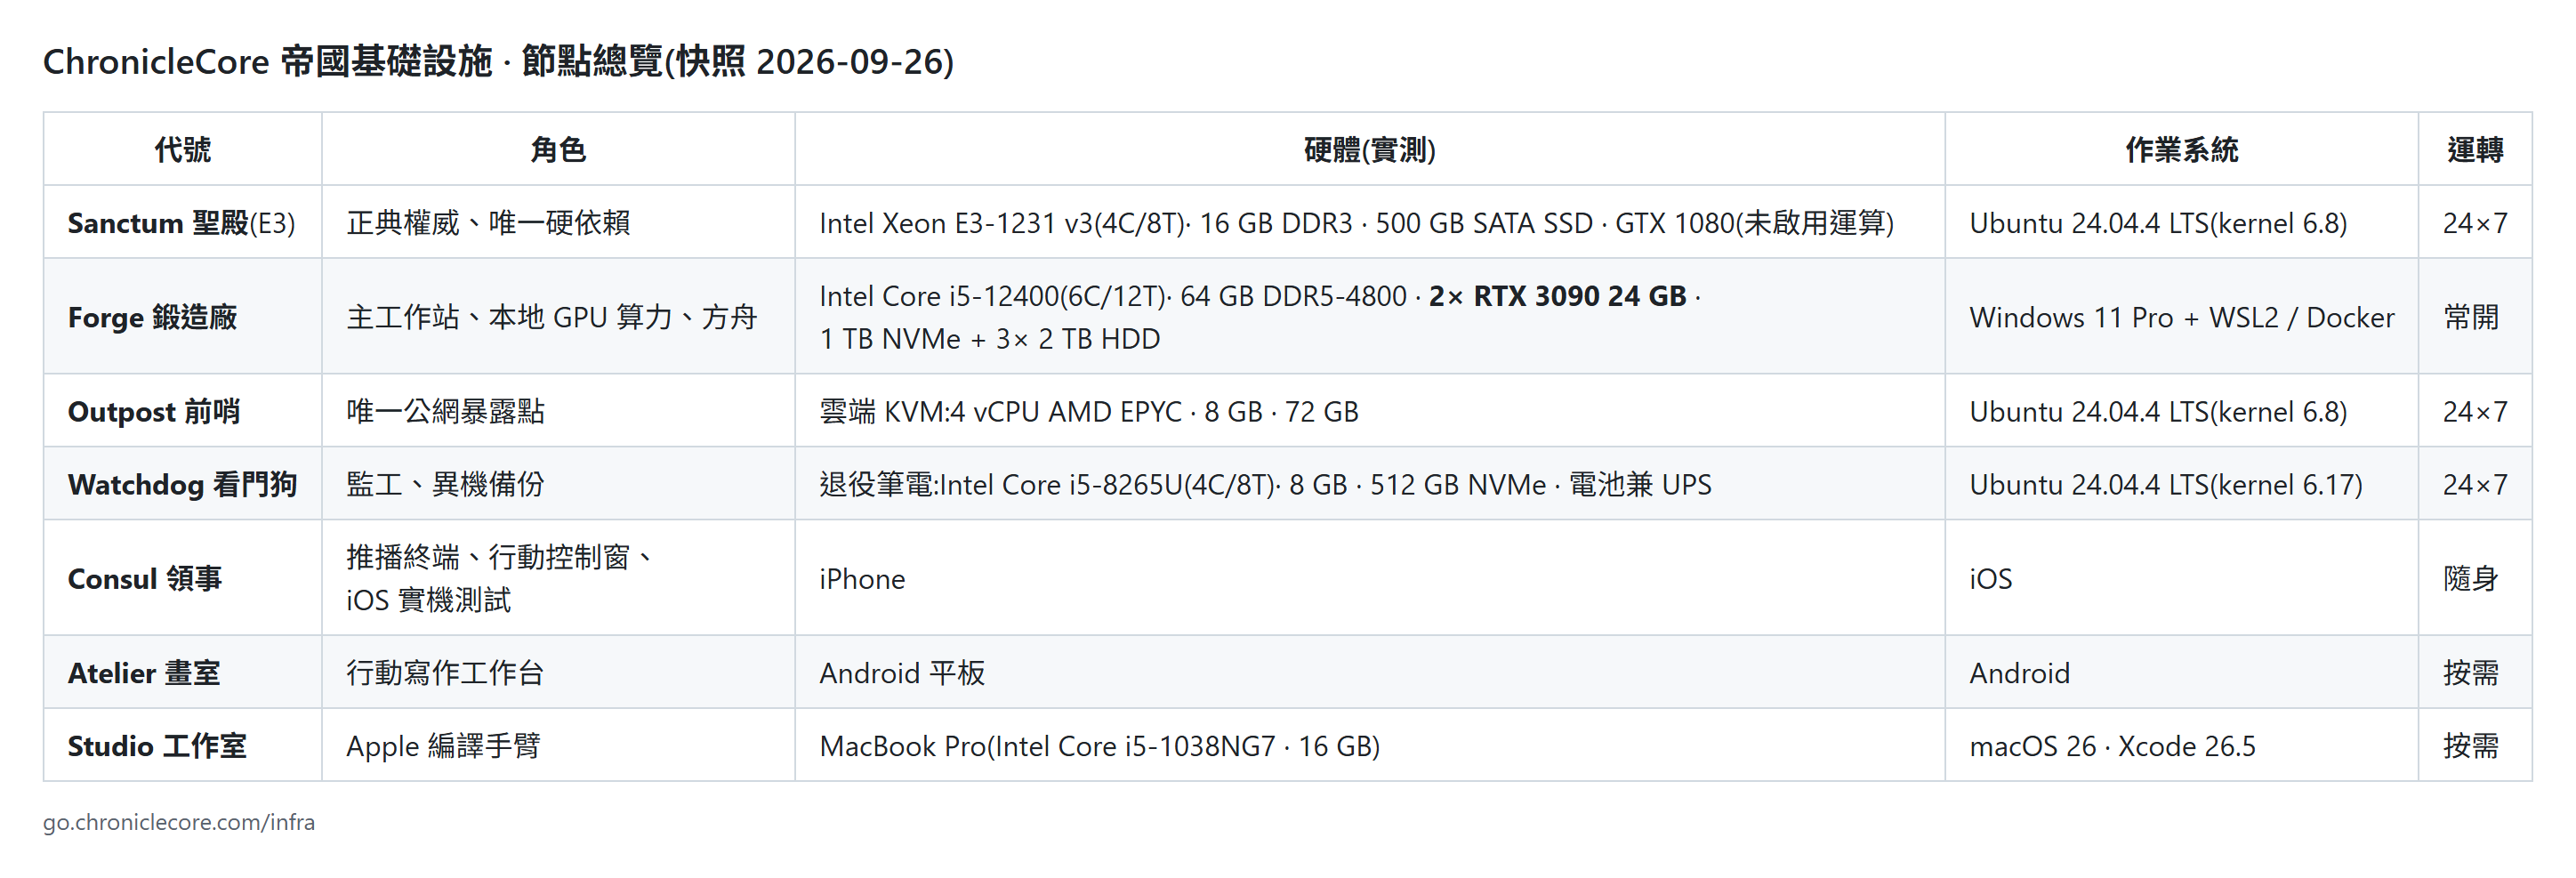
Windows 11 + WSL2 + Docker,跑 vLLM 0.30
模型:Qwen3.8-27B,AWQ W4A16 量化,單卡
我有兩個「腦」輪流用同一張卡(GPU1):
‧自動腦:Qwen3.8-27B 原版
context 32K,44–46 tok/s
‧對話腦:同基座的無審查社群微調版
context 56K(KV cache 用 fp8),42–43 tok/s
工具呼叫一次約 1.5 秒
共同參數:gpu util 0.92、max seqs 4、
tool parser qwen3_xml、reasoning parser qwen3、只載語言模型不載視覺編碼器
小提醒:綁卡請用 CUDA_VISIBLE_DEVICES,
只給 Docker 指定 --gpus device=1,模型照樣會載進另一張
------------
跑什麼
http://go.chroniclecore.com/d/vram.png
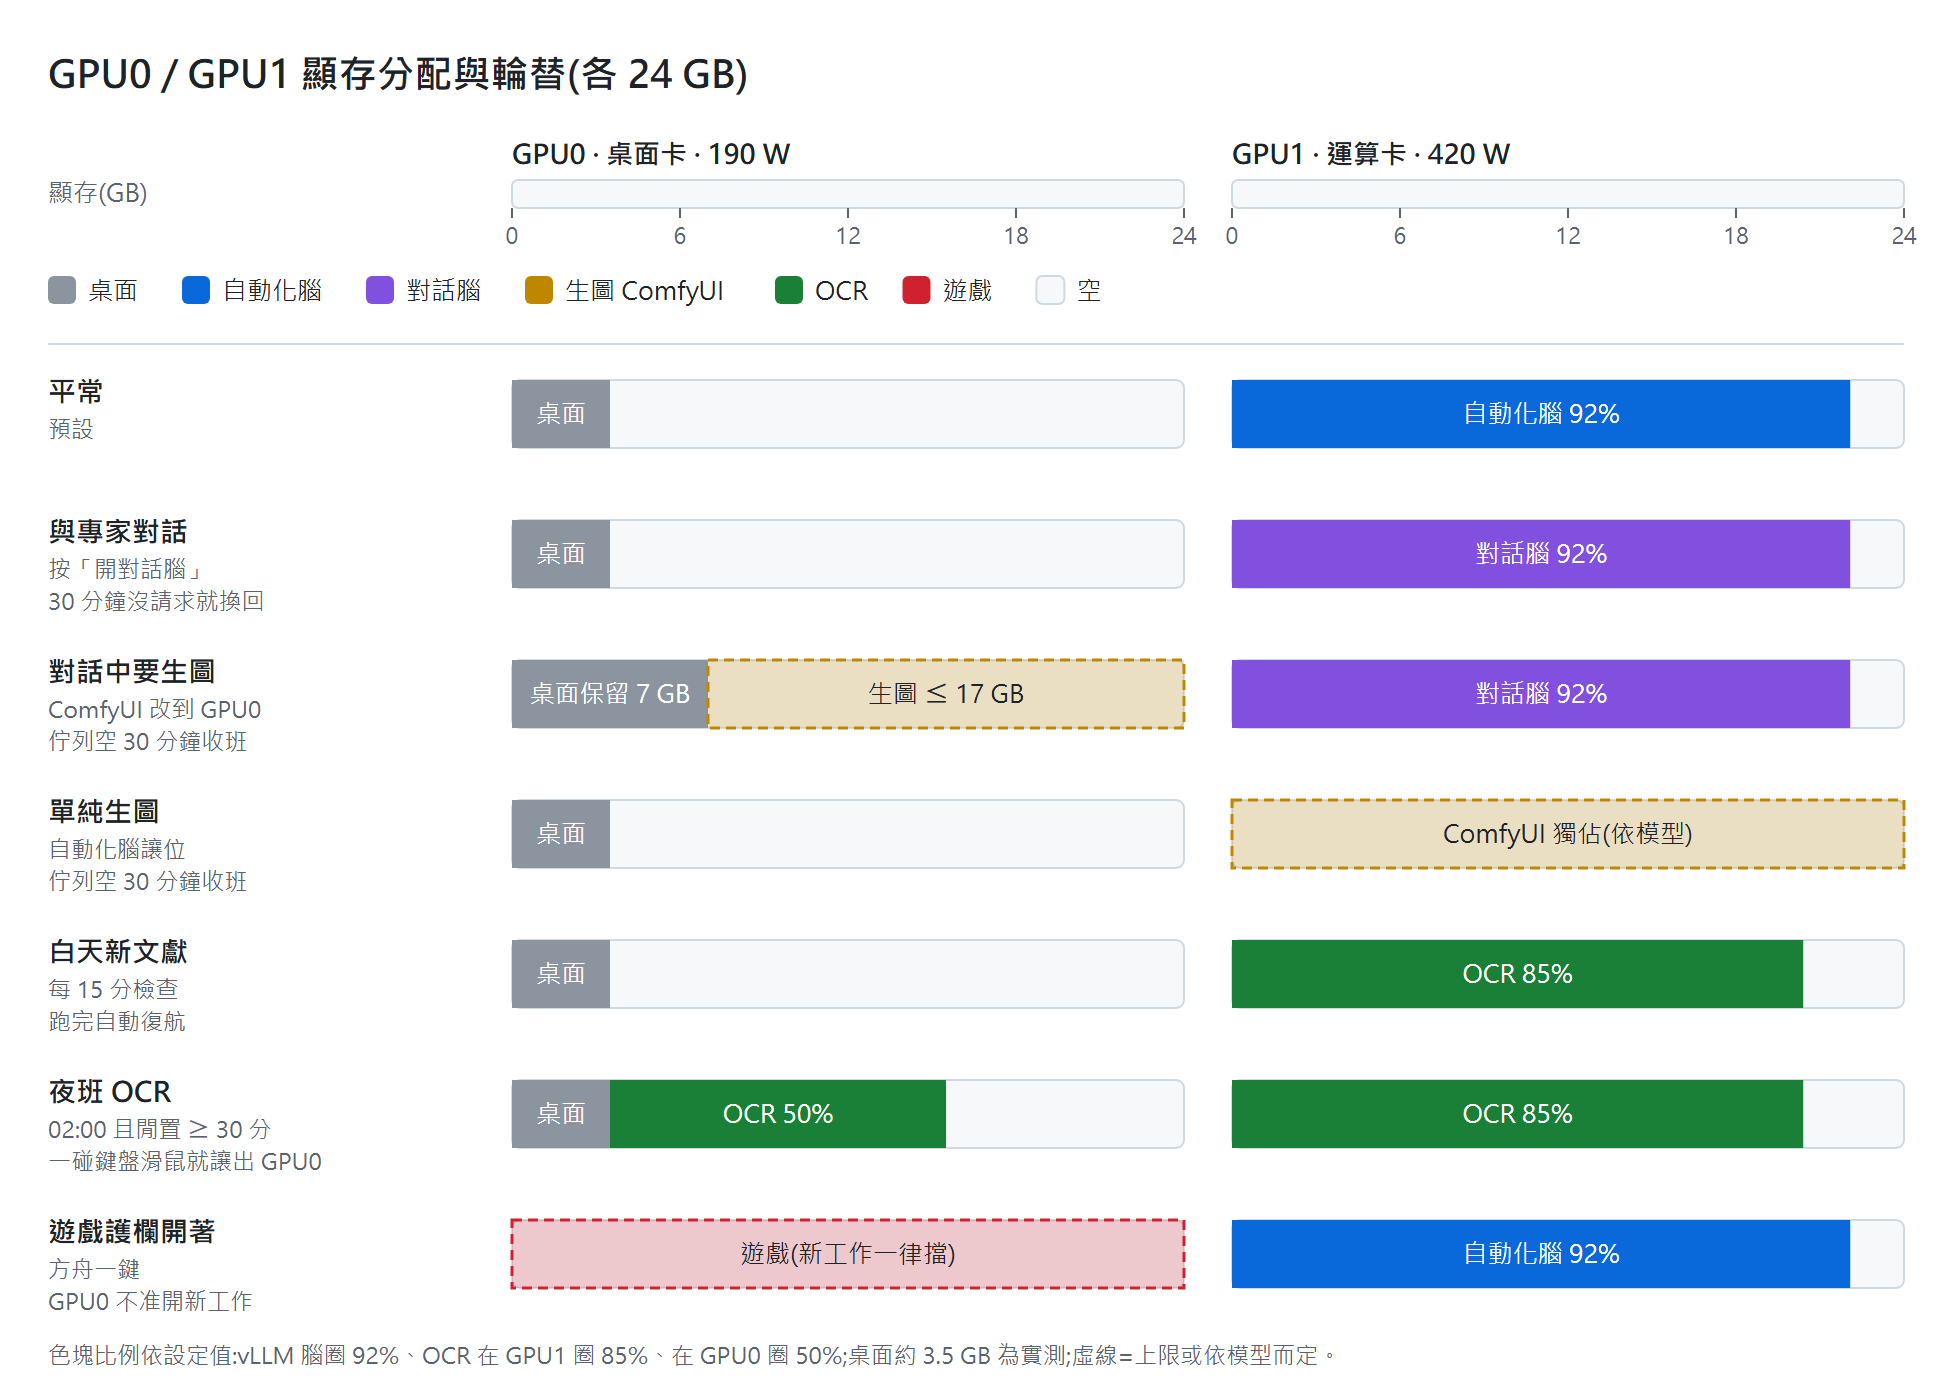
‧自動腦:我人不在電腦前的時候,半夜自動撈論文、抓時事、Agent總結記憶與做夢
整理、盤點、貼標籤,一堆亂七八糟的雜事,預計一部分可能會逐步換給jev
‧對話腦:要無審查的聊天時才換上來,30 分鐘沒人用自動換回自動腦,懂得都懂
‧OCR:baidu Unlimited-OCR 抽文獻全文,到目前上百本書、幾百篇論文
共約兩萬五千頁,平均 1.62 秒一頁
‧生圖:ComfyUI 跑 Krea 2 / Qwen-Image 2.1
‧embedding:bge-m3 丟給 CPU,不跟人搶顯存
寫程式我不用本地腦,還是雲端。當初說的 code review 初篩後來也沒做,
所以如果你是要給 coding agent 用,我這邊的數字參考就好。
我同意大部分資深工程師朋友玩 AI 的意見,寫程式用 costdown 的 LLM 在浪費生命。
(對 Gemini,我也在說你)
------------
雙卡的用途反轉
當初雙卡的目標是拆 Qwen3.6 35B MoE 給兩張跑,
但後來的 3.8 的 27B 更聰明,單卡就放得下。
35B MoE 每次運算據說也是秒級反應,但不確定是不是我沒有 NVLink 橋接器,
雙卡跑 35B 雖然還是快一點,但快不了多少也什麼優勢了。
所以現在是:
GPU0 = 桌面卡,接螢幕、打遊戲、OCR(趕工時),偶爾接生圖,可能會嘗試加掛jev-like
GPU1 = 運算卡,腦、OCR、生圖輪班
GPU0 壓在 190W,因為不小心吃滿的話桌面會沒畫面。
要生圖時會自動判斷:我在跟對話腦聊天,ComfyUI 就上 GPU0;
單純生圖,ComfyUI 就獨佔 GPU1,自動腦讓位。
所以正常需求要跑 27B,一張二手 3090 就夠了。
btw,
所以正常需求要跑 27B,一張二手 3090 就夠了。
btw,
GPU0 2023 年買 18000,GPU1 2026 4月年買 23000,現在一張會四萬了...
現在我也很難推大家玩雙 3090。
------------
踩坑(給考慮買二手3090的人)
用 Windows 是因為這台是家用電腦,工作跟打遊戲都在上面,代價是 WSL2 的坑一大堆
:
‧真正撞到的牆是 commit(實體記憶體+分頁檔),不是顯存
WSL 裡模型用多少顯存,Windows 就要記一筆等量的記憶體帳
有一晚實體記憶體還空 23GB,卻連報六次虛擬記憶體不足
現在 64GB + 112GB 分頁檔(放 NVMe),兩個腦還是不能同時開
→ 我曾經說 128GB 沒啥用這我真的錯了,但現在記憶體大家都知道是金條...
‧權重放在 Windows 路徑給 WSL 讀,vLLM 冷啟動 30–40 分鐘
搬進 Docker 原生卷後降到約 6 分鐘
‧兩張卡曾經在 Windows 下處於 SLI 模式,
桌面的顯存整份鏡像到運算卡,吃掉約 3.5GB
‧兩張 3090 的 vBIOS 跟預設功耗不一樣(350W / 420W),
買二手的話這個要看一下
‧疊羅漢最後沒改直立 XD
------------
設定很難,問 Claude
我剛開始用地端也是這個不會那個不會,
顯卡不會設定、LM Studio 或 Ollama 也不會設定,
可以跑但一直跳針,講話三不五時就斷掉,
那時候還是用 qwen3.6,我一度覺得地端 vLLM 什麼垃圾。
後來讓 Claude 看系統、全程操辦設定跟建設,現在要多舒服有多舒服。
遇到事情不懂就問 Claude/GPT,雲端地端用法不同,
外加雲端服務商隨時可以改規則、喊停服務,我希望我在不得不本地Coding前百度加油。
------------
隱藏招(未實測)
無審查對話腦掛 GPU1,理論上可以讓它當主腦去操作 GPU0 的 無審查 ComfyUI,
詳見這篇:[分享] Gemini + Comfyui + Qwen 實戰
https://www.ptt.cc/bbs/AI_Art/M.1790312988.A.3B4.html
[分享] Gemini + Comfyui + Qwen 實戰生圖 - AI_Art板 - Disp BBS
![[圖]]() ZMTL 先上幾張圖展示我這兩天用Gemini在幹嘛 對,他在幫我操控ComfyUI。 那個可以精細操作生圖細節+本機運算,但用起來超複雜的工具。 ComfyUI示意圖L 當我給他中文指令時, 他會自己翻譯成

------------
整套系統兩張 3090 其實是我一套多代理人系統的算力節點,
旁邊還有:
‧一台舊 Xeon 主機當常駐伺服器,保存資料、半夜派工作
‧一台螢幕壞掉的退役筆電當監工,電池直接當 UPS
‧一台雲端 VPS 負責所有對外服務,佈署 MCP
‧Tailscale:全部機器串成私網,
不用開 port、不用同一個區網,人在外面手機也連得回家
‧Bark:自架推播系統,
半夜收班報告、GPU 狀態、機器掛掉的告警都推到手機
完整的硬體、拓撲跟事故紀錄我整理在這裡:
https://go.chroniclecore.com/infra
ChronicleCore-Architecture/architecture/INFRASTRUCTURE_zh-TW.md at main · Zaious/ChronicleCore-Architecture · GitHub The conceptual architecture and governance whitepaper for ChronicleCore, an enterprise-grade Multi-Agent orchestration framework. - ChronicleCore-Arch ...
但說實在,細節我能講的也不多,
因為我的系統大概有 87% 我還在理解,從建設到寫出這篇說明都是靠 Claude 跟 Agent
,
我是負責爽(下判斷看結果)的,但你說這時代玩 AI 點點 Enter 就不用腦嗎?
我把這抽象的硬體系統跟 Agent 系統搭起來我每天都在覺得腦子不夠用。
這是我人生中玩過最好的策略 + 戰略遊戲 XD
--
AI_Art 生成式AI板 歡迎各方前來討論生成式AI相關議題!
──────────
◆ 從 Human-in-the-Loop → Human-AI Symbiosis (人機共生) ◆
LinkedIn:https://www.linkedin.com/in/zaious/
GitHub :https://github.com/Zaious
白皮書 :https://github.com/Zaious/ChronicleCore-Architecture
--
※ 發信站: 批踢踢實業坊(ptt.cc), 來自: 118.161.5.91 (臺灣)
※ 作者: ZMTL 2026-09-28 22:28:46
※ 文章代碼(AID): #1gkdcYs5 (PC_Shopping)
※ 文章網址: https://www.ptt.cc/bbs/PC_Shopping/M.1790605730.A.D85.html
※ 編輯: ZMTL (118.161.5.91 臺灣), 09/28/2026 22:29:12
※ 編輯: ZMTL (118.161.5.91 臺灣), 09/28/2026 22:29:58
![[圖]]()
![[圖]]()
--
※ 編輯: ZMTL (118.161.5.91 臺灣), 09/28/2026 22:29:58
→ : 我現在才看到上面那篇文,我很想說我這套也1F 118.161.5.91 台灣 09/28 22:32
→ : 差不多10萬把,3090半年前漲價前來算XD
→ : 差不多10萬把,3090半年前漲價前來算XD
推 : 早知到三年前就買對不對3F 220.142.51.174 台灣 09/28 22:35
→ : AI只是把重複作業和冗長的探索都幫你做
→ : 高階抽象的還是要自己來XD
→ : 就跟打孔機 組語 C/C++操作記憶體
→ : script language 一路抽象上來一樣
→ : 最近很多人轉換用更安全的rust
→ : AI只是把重複作業和冗長的探索都幫你做
→ : 高階抽象的還是要自己來XD
→ : 就跟打孔機 組語 C/C++操作記憶體
→ : script language 一路抽象上來一樣
→ : 最近很多人轉換用更安全的rust
→ : 要multi agent,雲地混串,還要跟服務商鬥智9F 118.161.5.91 台灣 09/28 22:37
→ : 也是因為有AI幫忙寫code10F 220.142.51.174 台灣 09/28 22:37
→ : 千金難買早知道,不然我去年就買5張11F 59.126.70.191 台灣 09/28 22:37
→ : 大腦不夠抽象也不行12F 118.161.5.91 台灣 09/28 22:37
→ : 5090了Orz13F 59.126.70.191 台灣 09/28 22:37
→ : 抽象思考也要訓練的14F 220.142.51.174 台灣 09/28 22:37
→ : 不過我在電蝦板喊VRAM才是王道,3090不死也15F 118.161.5.91 台灣 09/28 22:38
→ : 喊了好幾年了
→ : 喊了好幾年了
→ : 自從GPT 4出來之後,我睡覺的時間越來越17F 220.142.51.174 台灣 09/28 22:38
→ : 少
→ : 滿腦子都是新想法要AI去打工
→ : 就折騰了一兩年才發現記憶體多才是
→ : 王道
→ : 少
→ : 滿腦子都是新想法要AI去打工
→ : 就折騰了一兩年才發現記憶體多才是
→ : 王道
→ : 看到有人說3060買8G我都會攔,12G到現在還22F 118.161.5.91 台灣 09/28 22:39
→ : 有點用吧
→ : 有點用吧
→ : 記憶體永遠嫌不夠多24F 220.142.51.174 台灣 09/28 22:39
→ : 記憶體那真的... 想不到25F 118.161.5.91 台灣 09/28 22:39
→ : 12GB就玩玩小模型26F 220.142.51.174 台灣 09/28 22:39
→ : 8GB能玩的模型很少
→ : 27B要跑的好也要不少記憶體
→ : 現在AI盛行,多卡串聯又回來了
→ : 老黃前陣子丟一個串聯運算協定
→ : NVIDIA PAIR
→ : 8GB能玩的模型很少
→ : 27B要跑的好也要不少記憶體
→ : 現在AI盛行,多卡串聯又回來了
→ : 老黃前陣子丟一個串聯運算協定
→ : NVIDIA PAIR
→ : 我是怕老黃要放生3090了,但反正能用多久算32F 118.161.5.91 台灣 09/28 22:42
→ : 多久
→ : 多久
推 : 東西買一買發現deploy比較好玩34F 125.229.172.122 台灣 09/28 22:42
→ : 串聯多台裝置算力,自動分派任務協同推35F 220.142.51.174 台灣 09/28 22:43
→ : 畢竟deploy很有成就感阿
→ : 炫出來的token速度很有感
→ : 畢竟deploy很有成就感阿
→ : 炫出來的token速度很有感
→ : 反正這年頭除了組裝要靠自已,系統跟軟體38F 118.161.5.91 台灣 09/28 22:43
→ : Claude可能比你還熟
→ : 我另外幾臺電腦搞到它可以無頭遙控我都沒懂
→ : Claude可能比你還熟
→ : 我另外幾臺電腦搞到它可以無頭遙控我都沒懂
推 : NVLINK除了工作站外都沒了吧?41F 111.251.181.222 台灣 09/28 23:32
→ : 回樓上3090跟2080TI有,所以對岸有雙卡2080T42F 106.1.226.68 台灣 09/28 23:45
→ : I 22G的玩法
→ : 有推薦16GB VRAM的卡能裝啥嗎? 好像有看到Q
→ : WEN 3.8 27B ridge能用?
→ : I 22G的玩法
→ : 有推薦16GB VRAM的卡能裝啥嗎? 好像有看到Q
→ : WEN 3.8 27B ridge能用?
→ : 3.8 27B 塞一塞應該塞的進去46F 118.161.5.91 台灣 09/28 23:48
推 : 近期跑LLM已經朝向針對顯卡開發專屬的模型47F 59.115.175.159 台灣 09/28 23:49
→ : 或軟體,也有人是用專屬分枝,或許你可以請
→ : agents幫你查查近期有沒有合適的27B配3090
→ : 的方案,若有速度和上下文應該都可再提升
→ : 或軟體,也有人是用專屬分枝,或許你可以請
→ : agents幫你查查近期有沒有合適的27B配3090
→ : 的方案,若有速度和上下文應該都可再提升
推 : 16G跑27b別想了 又慢又一堆幻覺或跑不51F 172.58.116.193 美國 09/28 23:56
→ : 完
→ : 完
推 : 感謝分享53F 36.226.224.107 台灣 09/29 00:08
推 : 16GB別硬塞27B拉54F 220.142.51.174 台灣 09/29 00:43
推 : 大大請問你撈時事是用什麼API?55F 114.43.133.147 台灣 09/29 03:47
推 : 看起來好忙...還好我只打遊戲56F 123.194.42.140 台灣 09/29 06:14
推 : 感謝您的分享57F 114.33.74.238 台灣 09/29 06:32
推 : 推58F 122.117.59.50 台灣 09/29 06:56
推 : 如果你的16G是N卡,想跑的又是qwen3.8 27B59F 1.161.188.159 台灣 09/29 07:04
→ : ,那請選用自己顯卡專屬的ninfer版本,只能
→ : 性能極為驚人,這個出來,一下子讓一堆人對
→ : 本機跑LLM的要求的想法變落伍了
→ : ,那請選用自己顯卡專屬的ninfer版本,只能
→ : 性能極為驚人,這個出來,一下子讓一堆人對
→ : 本機跑LLM的要求的想法變落伍了
推 : 我有64g dram 跟5070ti, 是不是也適合63F 114.137.38.38 台灣 09/29 08:09
→ : 跑llm
→ : 跑llm
推 : 好奇16G A卡能跑什麼模型?65F 223.137.78.142 台灣 09/29 08:15
→ : LLM覺得最低還是要24g,但16g跑影音夠了66F 45.144.227.77 台灣 09/29 08:20
→ : 16g還是可以跑很多小模型,語音翻譯
→ : 解馬賽克修照片升頻影片很多,但LLM就算了
→ : 16g還是可以跑很多小模型,語音翻譯
→ : 解馬賽克修照片升頻影片很多,但LLM就算了
推 : 關於能不能跑,我是認為如果你就是只有16G69F 1.161.188.159 台灣 09/29 08:33
→ : VRAM,也不打算加錢升級,那你的選擇就是多
→ : 嚐試,而不是聽那些說你不能跑的話
→ : VRAM,也不打算加錢升級,那你的選擇就是多
→ : 嚐試,而不是聽那些說你不能跑的話
推 : 現在本地AI的資訊太多太雜,又一堆農場文72F 220.134.92.156 台灣 09/29 08:43
→ : 很多坑要自己進去踩到才知道
→ : 很多坑要自己進去踩到才知道
推 : 雙卡3090 27b 不是為了開大上下文嗎?74F 123.193.194.1 台灣 09/29 08:45
→ : 之前是啊,但實際上... 反正我還沒讓本地75F 118.161.5.91 台灣 09/29 08:58
→ : llm coding,用不到
→ : llm coding,用不到
推 : 好色喔77F 223.137.248.142 台灣 09/29 09:24
推 : 好巧 前幾天剛好新裝了 RTX3090 + RTX508078F 187.15.88.54 巴西 09/29 09:52
→ : https://i.imgur.com/ZNli70M.png
→ : 目前是限制功耗 250w 來跑
→ : 搭配社群上的 HyperQwen 速度還行
→ : 有空再研究下大大的做法,謝謝分享!
→ : https://i.imgur.com/ZNli70M.png
→ : 目前是限制功耗 250w 來跑
→ : 搭配社群上的 HyperQwen 速度還行
→ : 有空再研究下大大的做法,謝謝分享!

推 : 樓上你那張5080散熱怎麼辦83F 118.231.137.17 台灣 09/29 09:59
推 : 為何不直接上Linux? WSL2浪費記憶體頻寬84F 36.230.139.197 台灣 09/29 10:03
→ : 因為當你買了兩張顯卡後多少會覺得不玩遊戲85F 49.216.27.149 台灣 09/29 10:40
→ : 有點浪費…
→ : 有點浪費…
推 : 感謝分享!!87F 114.47.65.196 台灣 09/29 10:52
→ : 5080 散熱我沒處理欸,限制功耗後88F 187.15.88.85 巴西 09/29 10:53
→ : 5080溫度最高 70度,3090 溫度最高60度
→ : 3090 記憶體溫度最高 94度
→ : 覺得好像就不需要額外處理散熱了
→ : 主要是跑 LLM 沒用到 3090 的時脈
→ : 5080溫度最高 70度,3090 溫度最高60度
→ : 3090 記憶體溫度最高 94度
→ : 覺得好像就不需要額外處理散熱了
→ : 主要是跑 LLM 沒用到 3090 的時脈
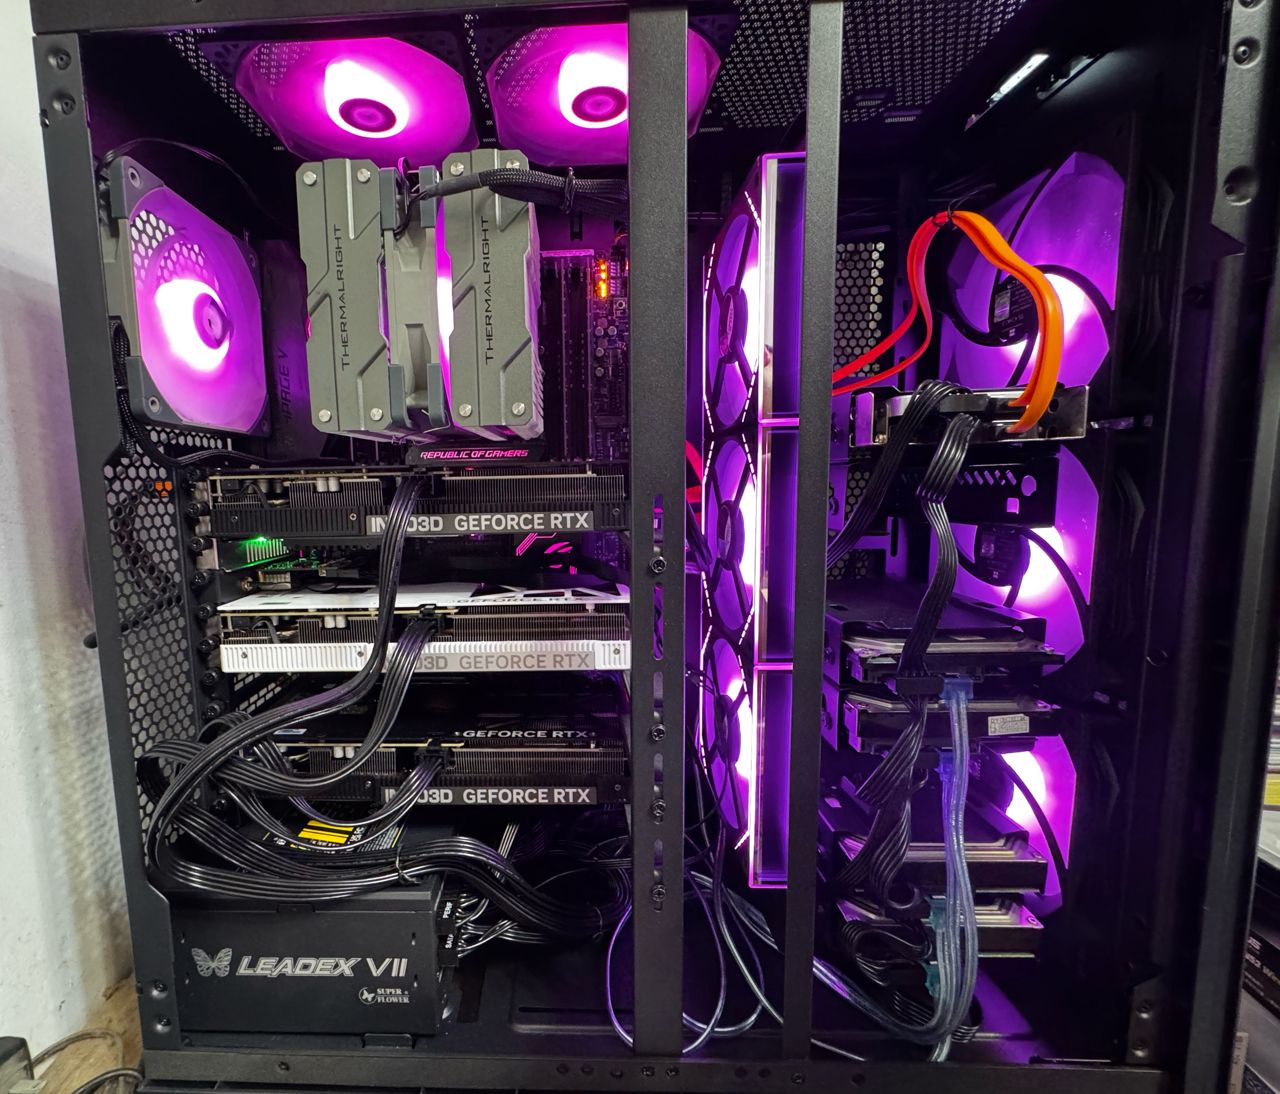
推 : https://i.mopix.cc/qxpX7O.jpg93F 36.230.139.197 台灣 09/29 11:12
→ : 這咖機殼散熱好, 透側又有壓克力可以訂製
→ : ,我還會想再買一次,改買Closed版,因為
→ : 在考慮充分散熱的情況下可以安裝四張顯卡
→ : 。
推 : 目前單卡滿載150W風扇轉速70%最高溫度77度
→ : ,雙卡並行各自90W風扇轉速30%最高不超過6
→ : 0度,三卡並行的話各自最高50W風扇0轉不超
→ : 過60度。
→ : RTX50多卡並行可以降低負載減少發熱,這是
→ : RTX30/40沒有的功能
推 : 3090的價值不在LLM而是ComyfUI, 文字/圖
→ : 片轉影片多卡並行相較於單卡歷時直接砍半
→ : 。
→ : 這咖機殼散熱好, 透側又有壓克力可以訂製
→ : ,我還會想再買一次,改買Closed版,因為
→ : 在考慮充分散熱的情況下可以安裝四張顯卡
→ : 。
推 : 目前單卡滿載150W風扇轉速70%最高溫度77度
→ : ,雙卡並行各自90W風扇轉速30%最高不超過6
→ : 0度,三卡並行的話各自最高50W風扇0轉不超
→ : 過60度。
→ : RTX50多卡並行可以降低負載減少發熱,這是
→ : RTX30/40沒有的功能
推 : 3090的價值不在LLM而是ComyfUI, 文字/圖
→ : 片轉影片多卡並行相較於單卡歷時直接砍半
→ : 。
→ : 樓上是多卡comfyui嗎?可以怎麼分,參考一下107F 60.250.61.214 台灣 09/29 11:43
→ : 生圖事業都做這麼大喔,都組這麼多108F 1.174.105.237 台灣 09/29 12:03
推 : 生圖API貴 抽籤次數多時自組沒比較貴109F 114.136.169.162 台灣 09/29 12:05
→ : 而且搞擦邊的也不會被平台打下來
→ : 而且搞擦邊的也不會被平台打下來
→ : 生單張圖不用搞工作流,要為某個專案批亮生111F 59.124.87.73 台灣 09/29 12:25
→ : 圖不用本地+自動化是在浪費生命
→ : 想像你今天要做款遊戲,100張卡,工作流做好
→ : 花個一兩小時決定風格,剩下99張不用半小時
→ : 圖不用本地+自動化是在浪費生命
→ : 想像你今天要做款遊戲,100張卡,工作流做好
→ : 花個一兩小時決定風格,剩下99張不用半小時
推 : 生圖才不用這麼多卡 肯定是玩H3之類的115F 124.218.206.38 台灣 09/29 12:44
推 : 撈輿情喔 買次級資料比較實在116F 203.204.195.174 台灣 09/29 12:46
→ : 哦看到有人問我時事撈什麼,基本上就關鍵字117F 60.250.61.214 台灣 09/29 12:51
→ : +google 搜尋api,arxiv撈論文,github看熱
→ : 點專案
→ : +google 搜尋api,arxiv撈論文,github看熱
→ : 點專案
推 : 推個,地端還是RAM要多多益善120F 60.250.130.216 台灣 09/29 14:51
推 : 玩地端真的也是要搶RAM,貴的搶不起只能121F 116.59.238.144 台灣 09/29 15:23
→ : 想辦法找高CP的零件來玩
→ : 真的不要只看雲端搶算力,忽略了地端現在
→ : 能做的工作也一直在提高
→ : 想辦法找高CP的零件來玩
→ : 真的不要只看雲端搶算力,忽略了地端現在
→ : 能做的工作也一直在提高
推 : 記憶體、VRAM永遠不會嫌多125F 182.233.210.24 台灣 09/29 16:54
--
※ 看板: PC_Shopping 文章推薦值: 0 目前人氣: 0 累積人氣: 33
→
guest
回列表(←)
分享